2026-08-27 · 10:30
水群时想到好玩的东西。
《民族比例不正常群聊分析》
癫子群聊里活跃聊天的一共 10 个人,统计民族为:土家族 5、苗族 1、汉族 4。户籍均为重庆户口,看似民族比例不正常。
设
七普重庆少数民族占比 6.77%,代入
六万三千分之一,已经很小了。
但是如果加入老家信息再算一次。
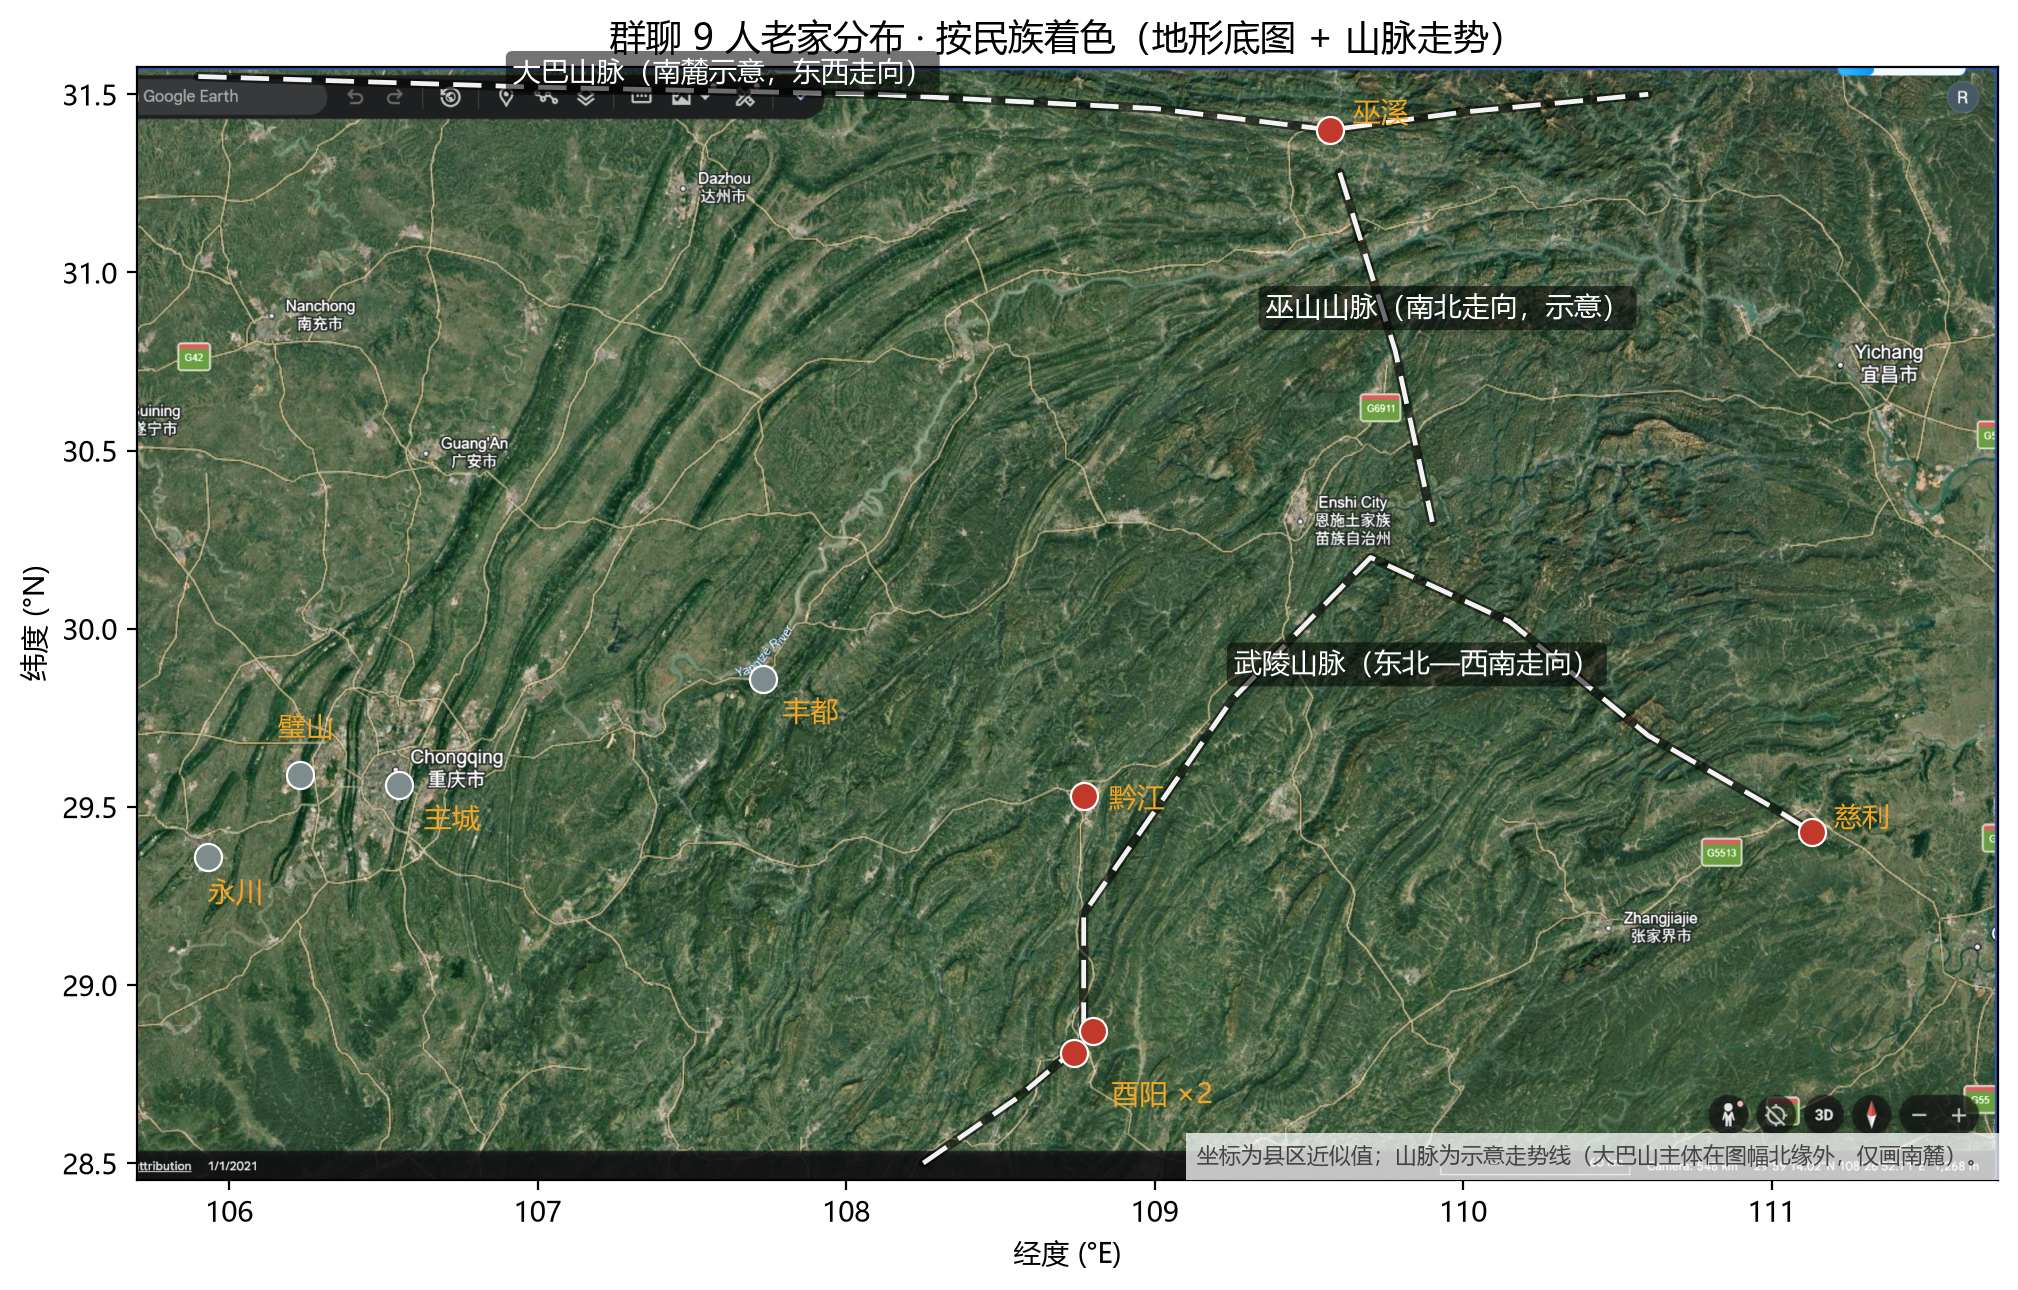
统计结果为:老家分别在黔江、酉阳(两人)、巫溪(近巴东、恩施片)、湖南慈利、贵州。
| 癫子 | 老家指向 | |
|---|---|---|
| 土家族 ×1 | 黔江 | 0.71 |
| 土家族 ×2 | 酉阳 | 0.93 ×2 |
| 土家族 ×1 | 巫溪(近巴东、恩施片) | 0.50 |
| 土家族 ×1 | 湖南慈利 | 0.61 |
| 苗族 ×1 | 贵州 | 0.80 |
| 汉族 ×4 | 重庆 | 0.03 ×4 |
期望少数民族人数约 4.6(
回到较正常概率。
最后算一下分布程度,也就是人员分布是否平衡。这次用县政府驻地级坐标(WGS84,误差约 1~2 km)和椭球大圆距离重新算。
设
其中
总体(10 人,贵州用凯里代表):
10 个点的平均中心
其中
分组看更不平衡:
| 组别 | 两两平均距离 | 标准距离 | 结构 |
|---|---|---|---|
| 汉族 4 人 | 98 km | 69 km | 主城周边一小簇 |
| 土家 5 人 | 194 km | 137 km | 沿走廊一条带 |
| 少数民族 6 人(含凯里) | 253 km | 185 km | 被凯里向南拉长 |
| 组间(24 对) | 305 km | — | 是汉族组内的 3.1 倍 |
组间与组内的分离度
重心也分得很开:汉族重心(106.6°E, 29.6°N)与土家重心(109.4°E, 29.6°N)相距约 271 km,是汉族组内平均距离的 2.8 倍;含凯里的少数民族重心(109.2°E, 29.1°N)与汉族重心相距 254 km。最近邻指数:
其中
结论:人员分布是"西边一小簇 + 东边一条带"的双团结构,民族和空间位置高度绑定。
Code
from itertools import combinations
import math
import numpy as np
from geopy.distance import geodesic
from scipy.spatial import ConvexHull

# (地名, 经度, 纬度, 分组)  分组: T=土家, H=汉族, M=苗族
people = [
    ("黔江", 108.7707, 29.5332, "T"),
    ("酉阳A", 108.7677, 28.8411, "T"),
    ("酉阳B", 108.7677, 28.8411, "T"),
    ("巫溪", 109.5701, 31.3984, "T"),
    ("慈利", 111.1394, 29.4296, "T"),
    ("永川", 105.9274, 29.3561, "H"),
    ("丰都", 107.7308, 29.8635, "H"),
    ("璧山", 106.2278, 29.5923, "H"),
    ("主城", 106.5516, 29.5630, "H"),
    ("凯里", 107.9771, 26.5829, "M"),
]
names = [p[0] for p in people]
group = {p[0]: p[3] for p in people}

# 两两椭球大圆距离 (km), geopy 参数顺序为 (纬度, 经度)
dist = {}
for i, j in combinations(range(len(people)), 2):
    a = (people[i][2], people[i][1])
    b = (people[j][2], people[j][1])
    dist[(names[i], names[j])] = geodesic(a, b).km

D = np.array(sorted(dist.values()))
mean_d = D.mean()
std_d = D.std(ddof=0)
print("mean=%.1f median=%.1f std=%.1f CV=%.2f min=%.1f max=%.1f km"
      % (mean_d, np.median(D), std_d, std_d / mean_d, D[0], D[-1]))

# 基尼系数
G = sum((2 * k - len(D) - 1) * D[k] for k in range(len(D))) / (len(D) ** 2 * mean_d)
print("Gini=%.3f" % G)

# 局部等距投影, 参考纬度 29.5N
ref = math.radians(29.5)

def to_xy(lon, lat):
    return (lon - 105.0) * 111.32 * math.cos(ref), (lat - 28.0) * 111.32

# 平均中心与标准距离
xy = [to_xy(p[1], p[2]) for p in people]
cx = np.mean([x for x, y in xy])
cy = np.mean([y for x, y in xy])
clon = cx / (111.32 * math.cos(ref)) + 105.0
clat = cy / 111.32 + 28.0
sd = math.sqrt(np.mean([geodesic((clat, clon), (p[2], p[1])).km ** 2 for p in people]))
print("mean center=%.3fE %.3fN  standard distance=%.1f km" % (clon, clat, sd))

# 分组两两距离统计
def pair_stats(pred):
    vals = [v for (a, b), v in dist.items() if pred(group[a], group[b])]
    return np.mean(vals), np.std(vals, ddof=0), len(vals)

mT = pair_stats(lambda g1, g2: g1 == "T" and g2 == "T")
mH = pair_stats(lambda g1, g2: g1 == "H" and g2 == "H")
mM = pair_stats(lambda g1, g2: g1 != "H" and g2 != "H")
mB = pair_stats(lambda g1, g2: (g1 == "H") != (g2 == "H"))
print("Tujia within: mean=%.1f pair_std=%.1f n=%d" % mT)
print("Han within: mean=%.1f pair_std=%.1f n=%d" % mH)
print("minority within: mean=%.1f pair_std=%.1f n=%d" % mM)
print("between: mean=%.1f pair_std=%.1f n=%d" % mB)

# 分组标准距离 (到组平均中心的距离)
def group_sd(groups):
    sel = [p for p in people if group[p[0]] in groups]
    gx = np.mean([to_xy(p[1], p[2])[0] for p in sel])
    gy = np.mean([to_xy(p[1], p[2])[1] for p in sel])
    clon = gx / (111.32 * math.cos(ref)) + 105.0
    clat = gy / 111.32 + 28.0
    return math.sqrt(np.mean([geodesic((clat, clon), (p[2], p[1])).km ** 2 for p in sel]))

print("Han std dist=%.1f" % group_sd({"H"}))
print("Tujia std dist=%.1f" % group_sd({"T"}))
print("minority std dist=%.1f" % group_sd({"T", "M"}))

# 分组重心
def center_of(groups):
    sel = [p for p in people if group[p[0]] in groups]
    gx = np.mean([to_xy(p[1], p[2])[0] for p in sel])
    gy = np.mean([to_xy(p[1], p[2])[1] for p in sel])
    return gx / (111.32 * math.cos(ref)) + 105.0, gy / 111.32 + 28.0

cH = center_of({"H"})
cT = center_of({"T"})
cMin = center_of({"T", "M"})
print("Han center=%.3fE %.3fN" % cH)
print("Tujia center=%.3fE %.3fN" % cT)
print("minority center=%.3fE %.3fN" % cMin)
print("Han-Tujia dist=%.1f km" % geodesic((cH[1], cH[0]), (cT[1], cT[0])).km)
print("Han-minority dist=%.1f km" % geodesic((cH[1], cH[0]), (cMin[1], cMin[0])).km)

# 最近邻指数 R (凸包面积法)
pts = np.array([to_xy(p[1], p[2]) for p in people])
hull = ConvexHull(pts)
verts = pts[hull.vertices]
area = 0.5 * abs(sum(verts[i, 0] * verts[(i + 1) % len(verts), 1]
                     - verts[(i + 1) % len(verts), 0] * verts[i, 1]
                     for i in range(len(verts))))
obs_nn = np.mean([min(geodesic((people[i][2], people[i][1]),
                               (people[j][2], people[j][1])).km
                      for j in range(len(people)) if j != i)
                  for i in range(len(people))])
exp_nn = 0.5 * math.sqrt(area / len(people))
print("hull=%.0f km2  NN obs=%.1f exp=%.1f R=%.2f" % (area, obs_nn, exp_nn, obs_nn / exp_nn))